كيف بنينا نواة Atmet: عقل يفهم الشركة قبل أن يعمل فيها الذكاء الاصطناعي
كيف بنينا نواة Atmet: عقل يفهم الشركة قبل أن يعمل فيها الذكاء الاصطناعي
قمنا ببناء Atmet وهو منتج يمكن الشركاء من بناء وكلاء الذكاء الإصطناعي وأتمتة سير عمل أي قسم داخل الشركة، الفرق الجوهري بين Atmet وأي منتج ذكاء إصطناعي آخر هي القاعدة المعرفية والتي تسمح للمستخدم ببناء وكيل لأتمتة سير العمل وربط تطبيقات خارجية وإتخاذ إجراءات داخل كل تطبيق بدون الحاجة إلى تعليم هذا الوكيل في كل مرة، حتى لو احتاج العميل إلى تغيير نموذج الـLLM أو تشغيل نموذج محلي.لكن عندما بنينا Atmet لم يكن الهدف هو مجرد أداة للأتمتة مثل n8n أو zapier، او مع مجرد عدة مزايا إضافية مثل تشغيل النموذج محلياً وواجهة أفضل لتشغيل الوكلاء، بل أردناه بأن يكون عقل الشركة والذي يسمح لفريق الشركة ليس فقط بأتمتتة سير العمل بل بجعل Atmet قاعدة معرفية للإستعلام، بناء الوكلاء وأتمتة العمل.عندما بدأنا العمل مع عميل ولنسميه X، لم تكن المشكلة في نقص المعلومات. بالعكس، الشركة تعرف الكثير، لكن هذه المعرفة تراكمت على مدار سنوات داخل أماكن مختلفة. الملفات موجودة في Google Drive، والنقاشات والقرارات اليومية في Slack، وبيانات العملاء داخل CRM، والمشاريع والمهام في أنظمة أخرى، والـ Code في GitHub، إضافة إلى قواعد بيانات وملفات Excel وأنظمة داخلية تستخدمها الفرق داخل الشركة كل يوم.
اسأل شخص من المبيعات عن عميل معين، وسيعطيك جزءًا من الصورة. اسأل فريق العمليات، وستحصل على جزء آخر. وقد تكتشف أن قراراً مهماً اتخذه الفريق قبل أشهر موجود فقط داخل محادثة في Slack، بينما التفاصيل التقنية للقرار موجودة في GitHub، وحالة المشروع الحالية موجودة في نظام آخر.
وهذا طبيعي. هكذا تعمل الشركات أصلاً.
المشكلة بدأت عندما أردنا أن نجعل الذكاء الاصطناعي يعمل داخل هذه البيئة. إذا أردنا بناء Atmet وهو منتج يمكن الشركاء من أتمتة سير عملها وربطها التطبيقات عن طريق بناء وكلاء ذكاء إصطناعي أو Agents لكل قسم ولكل مهمة، على سبيل المثال وكيل لقسم المبيعات وآخر للعمليات، وأتمتة تتابع مشروع معين، أو حتى Model يجيب عن أسئلة الموظفين، فهل سنشرح الشركة من البداية لكل واحدة منها؟ وماذا لو اختلف نموذج عمل الشركة أو قسم منها؟
هذا السؤال قادنا إلى الفكرة التي بُنيت Atmet حولها.
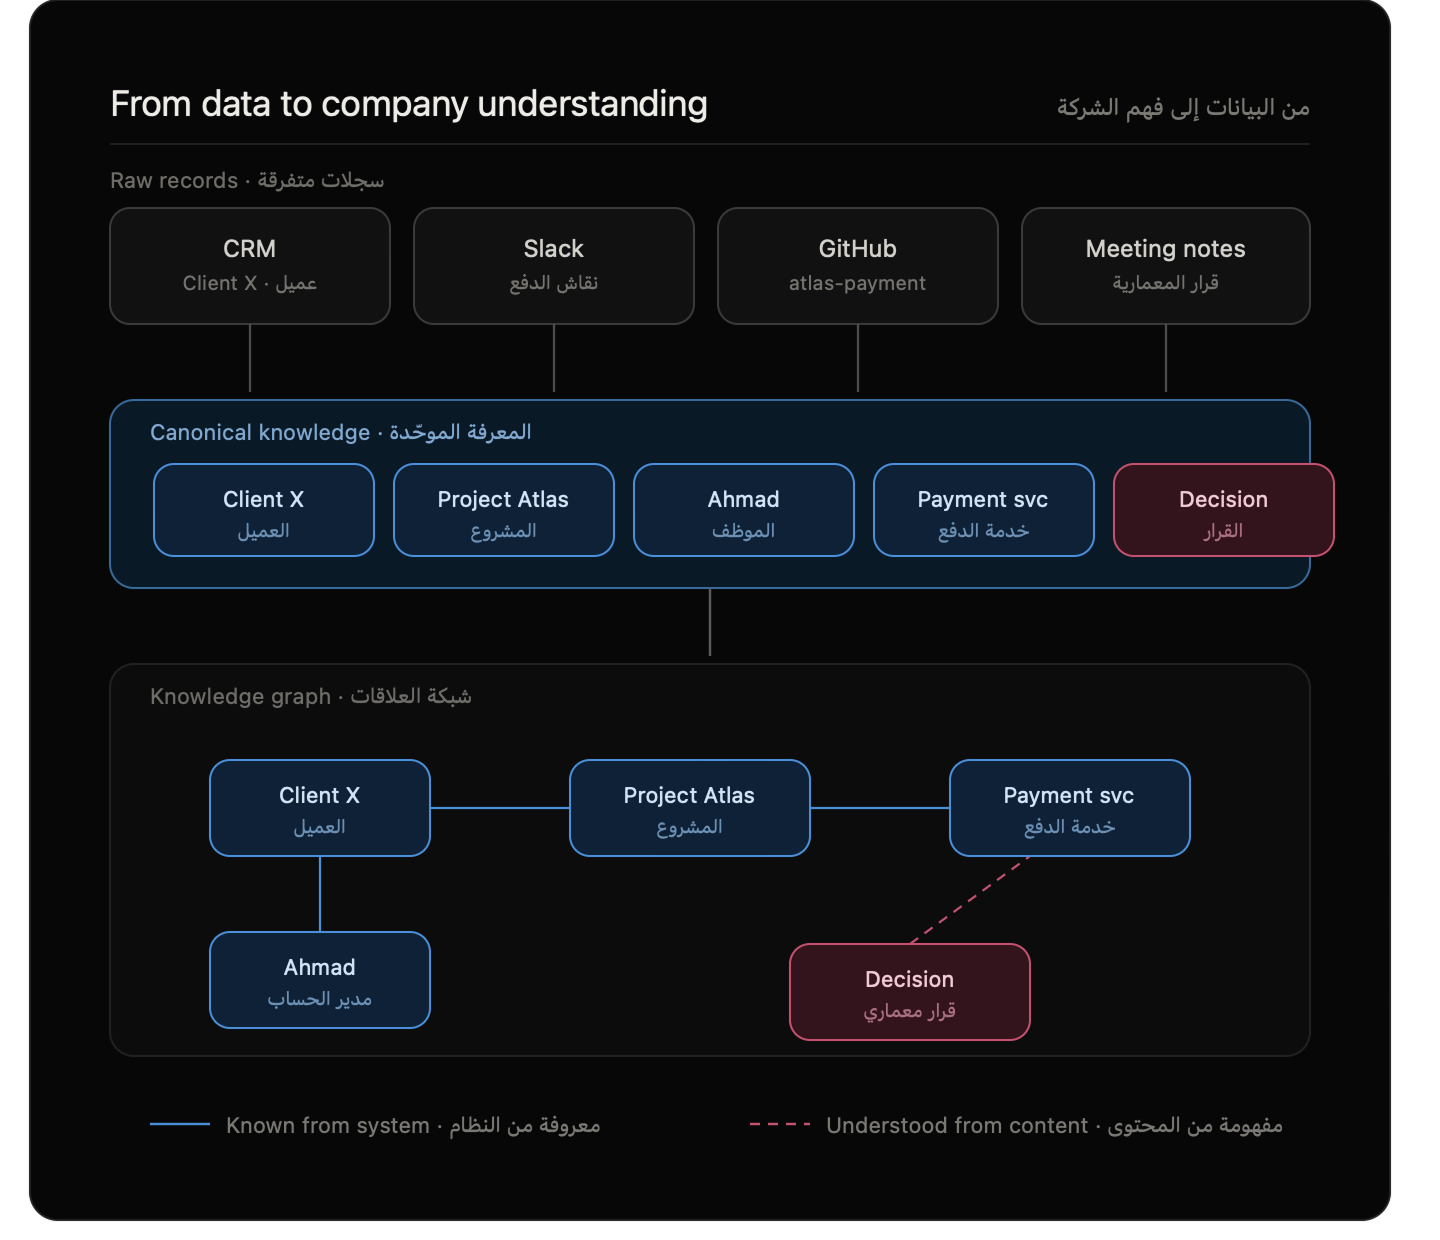
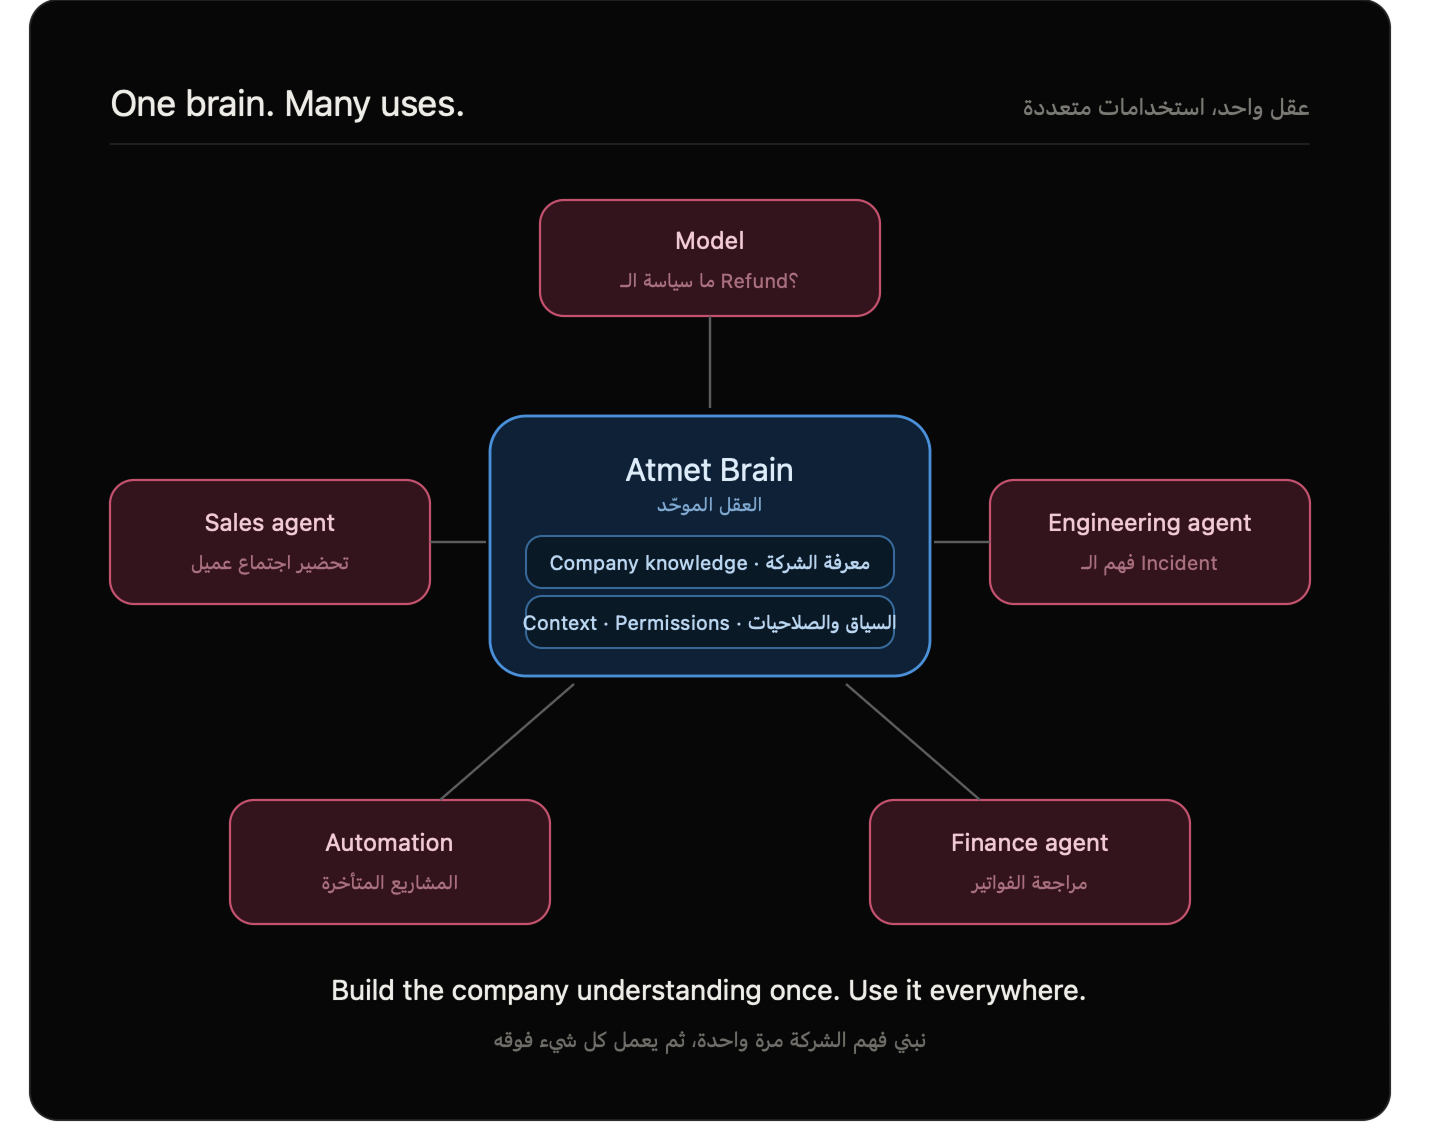
نبني النموذج الذي يبني عقل الشركة أولًا. بعد ذلك يمكن لأي Model أو Agent أو Automation أن يعمل كطبقة ثانية فوقه.
هذه هو الـ Brain في Atmet. ليست Knowledge Base إضافية داخل المنتج، وليست مجرد طريقة للبحث في الملفات. هو النواة الذي تتصل به معرفة الشركة، وأنظمتها، وصلاحياتها، وعلاقاتها، ثم تستخدمه بقية أجزاء Atmet لفهم ما يحدث قبل الإجابة أو اتخاذ أي إجراء.
لم نرد أن ننقل الشركة إلى Atmet
أول حل يخطر في البال عند الحديث عن قاعدة معرفة الشركات هو جمع كل شيء في مكان واحد. تبدو الفكرة منطقية: ننقل الملفات والمعلومات إلى منصة مركزية، وبعد ذلك يصبح كل شيء أسهل.
لكن عندما تنظر إلى طريقة عمل الفرق على أرض الواقع، تكتشف أن هذا ليس عملياً.
فريق المبيعات يستخدم CRM لأنه مناسب للعملاء والفرص. المطورون يستخدمون GitHub لأن النقاش حول الـ Code يجب أن يبقى قريباً من الـ Code. القرارات السريعة تحدث في Slack أو Pumble، والوثائق والدوكيومنتس مخزنة في Google Drive أو Notion، بينما تعتمد المالية والعمليات على أنظمة مختلفة تماماً.
إذا طلبنا من الجميع ترك هذه الأدوات أو نسخ المعرفة منها يدوياً إلى Atmet، فنحن لم نحل المشكلة. أضفنا نظاماً جديداً على الموظفين تعلمه وهو مايتعارض مع الرؤية الأساسية لـAtmet.
لذلك أخذنا الاتجاه المعاكس. لا نريد من قاعدة المعرفة أن تنتقل إلى Atmet، بل نريد Atmet أن تصل إليها حيث هي موجودة.
يتصل Atmet بالأنظمة التي تستخدمها الشركة أصلًا، وتقرأ منها باستمرار، ثم تبني فوقها طبقة معرفية موحدة. Slack يبقى Slack، وGitHub يبقى GitHub، وCRM يبقى CRM. الموظف لا يحتاج إلى تغيير طريقة عمله، لكن الذكاء الاصطناعي يبدأ برؤية هذه الأنظمة كأجزاء مترابطة من شركة واحدة.
وهنا بدأ أول فرق حقيقي بالنسبة لنا: نحن لا نحاول توحيد المكان الذي تعيش فيه المعرفة، بل نحاول توحيد الطريقة التي يفهمها بها الذكاء الاصطناعي.
اكتشفنا بسرعة أن Vector Database ليست Knowledge Base
من السهل اليوم بناء تجربة أولية لقاعدة للمعرفة. تأخذ الملفات، تقسمها إلى أجزاء، تنشئ Embeddings، تخزنها في Vector Database، ثم تستخدم RAG لإرسال الأجزاء الأقرب إلى السؤال نحو الـModel.
هذا مفيد، وفي كثير من الحالات يعطي نتائج جيدة.
لكن عند العميل الذي سميناه X، بدأت الأسئلة الأصعب بالظهور بسرعة. ماذا لو كانت هناك نسختان من عقد معين حول طريقة عمل قسم المالية مثلاً، واحدة حديثة وأخرى قديمة؟ أو كيف سيعرف النظام أن Project Atlas المذكور داخل Slack هو المشروع نفسه الموجود داخل نظام إدارة المشاريع؟ ماذا لو كانت الإجابة رقماً موجوداً في Database وليست فقرة داخل ملف؟ وماذا يحدث إذا وجد النظام المعلومة الصحيحة، لكن المستخدم لا يملك صلاحية رؤيتها أصلًا؟
عندها أصبح واضحاً أن Vector Search جزء من الحل، وليس الحل نفسه.
بدأ شكل الـ Brain يتوسع. احتجنا إلى الاحتفاظ بالبيانات الأصلية، وإلى طبقة موحدة لفهم قاعدة المعرفة، وإلى Metadata تصف كل معلومة، وإلى فهارس للبحث، وإلى Knowledge Graph تفهم العلاقات، وإلى صلاحيات وإصدارات وتاريخ للتغييرات.
لم نضع هذه الأشياء لأننا أردنا رسم Architecture كبير. كل طبقة ظهرت لأننا وصلنا إلى سؤال لم تستطع الطبقة السابقة الإجابة عنه.
كان علينا أن نعطي قاعدة المعرفة لغة مشتركة
خذ مثالًا بسيطاً. هناك محادثة في Slack حول مشكلة مع X، وسجل للعميل نفسه داخل CRM، ومشروع مرتبط به داخل نظام إدارة المشاريع، وPull Request في GitHub حول اصلاح هذه المشكلة التي يناقشها الفريق.
بالنسبة إلى كل نظام، هذه معلومات مختلفة تماماً. لكل منها شكل مختلف، وحقول مختلفة، وطريقة مختلفة للوصول إليها. لكن بالنسبة إلى عقل الشركة، هي أجزاء من القصة نفسها.
لهذا احتجنا إلى Canonical Knowledge.
الفكرة ليست تحويل كل شيء إلى نص متشابه، بل إنشاء شكل داخلي موحد يستطيع الـ Brain من خلاله التعامل مع قاعدة المعرفة. عندما تدخل معلومة إلى Atmet، نريد أن نعرف محتواها، ومصدرها، ونوعها، وتاريخها، والمشروع أو العميل المرتبط بها، والأشخاص الذين تظهر أسماؤهم فيها، وصلاحيات الوصول إليها، وأي علاقات نعرفها عنها.
الـ Connector الخاص بـ Slack يعرف كيف يقرأ Slack. والـ Connector الخاص بـ GitHub يفهم المستودعات والـ Commits والـ Pull Requests. والـ Connector الخاص بـ CRM يعرف كيف يقرأ العملاء والفرص والحسابات. لكن بعد دخول المعلومات إلى الـ Brain، لا نريد من بقية النظام أن تتعامل مع كل مصدر كأنه عالم منفصل.
هذا القرار أصبح مهماً جداً مع الوقت. عندما يربط X نظاماً جديداً، لا نحتاج إلى إعادة بناء كل Agent حتى تعرف كيف تتعامل معه. نربط المصدر بالـ Brain مرة واحدة، ومن هناك تستطيع أي Model أو Agent أو Automation مصرح له ان يكون يكون بإمكانه الاستفادة منه.
بعبارة أبسط، نحن لا نضيف النظام الجديد إلى Agent واحد فق. نحن نضيفه إلى عقل الشركة.
المعلومات وحدها لم تكن كافية
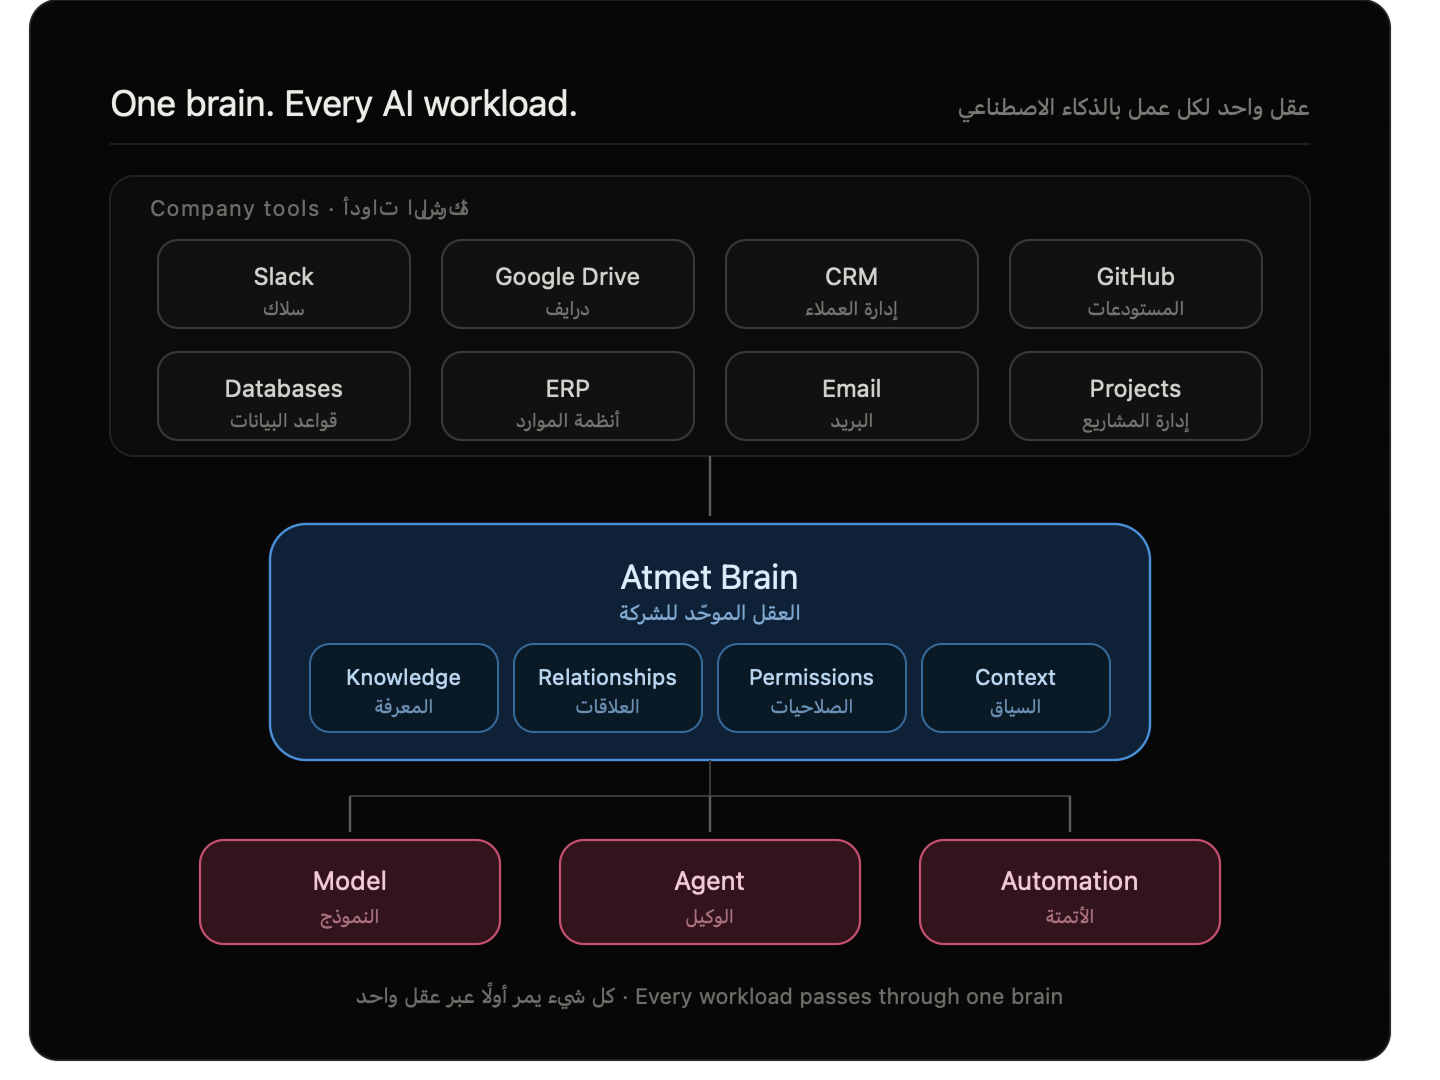
مع الوقت اكتشفنا أن قاعدة معرفة الأشياء وحدها ليست كافية، لأن القيمة الحقيقية تظهر أحياناً في العلاقة بينها. قد يكون X مرتبطاً بمشروع معين، وهذا المشروع يديره فريق محدد، وقرار مهم بشأنه اتخذ في اجتماع سابق ثم أدى إلى تعديل في الـ Code. بعد فترة، قد يظهر هذا التعديل مرة أخرى في مشكلة ناقشها الفريق داخل Slack، ونكتشف أن مهندساً معيناً شارك في معظم النقاشات المتعلقة بهذا الجزء من النظام.
إذا تعاملنا مع كل عنصر بمفرده، سنتمكن من العثور على المعلومات، لكننا لن نفهم الصورة كاملة. وهنا يأتي دور Knowledge Graph. هي لا تساعد الـ Brain على معرفة ما الموجود فقط، بل على فهم كيف ترتبط المعرفة ببعضها.
بعض العلاقات تكون واضحة أصلًا ولا تحتاج إلى AI لاكتشافها. إذا كان CRM يحدد أن أحمد هو المسؤول عن Client X، فهذه علاقة نعرفها مباشرة. وإذا كان نظام إدارة المشاريع يحدد أن مهمة معينة تنتمي إلى Project Atlas، فلا يوجد شيء نحتاج إلى استنتاجه هنا.
لكن العلاقات ليست دائماً بهذه الوضوح. قد يظهر اسم المشروع داخل محادثات ووثائق واجتماعات ومستودع Code من دون وجود خانة تقول صراحة إن كل هذه الأشياء مرتبطة به. هنا يستطيع AI استخراج Entities والعلاقات المحتملة بينها، ثم تستخدم الـ Brain هذه الإشارات لبناء صورة أوسع عن الشركة.
لم نرد أن نرسم الـ Knowledge Graph يدويًا، لأن الشركة تتغير أسرع من قدرة أي شخص على تحديثها. وفي الوقت نفسه، لم نرد أن تعتمد كل العلاقات على تخمين الـ Model. لذلك نجمع بين العلاقات التي تأتي مباشرة من الأنظمة، والعلاقات التي يستخرجها الذكاء الاصطناعي من المحتوى، مع الاحتفاظ بدرجة الثقة ومصدر كل علاقة.
ومع دخول المزيد من قاعدة المعرفة، تصبح هذه الشبكة أغنى. الـ Knowledge Graph ليست رسماً ننشئه أثناء إعداد النظام ثم ننساه، بل جزء حي من الـ Brain يتغير مع الشركة.
Vector Search كانت ممتازة، لكنها ترى جزءاً فقط من الصورة
تعمل Vector Search بشكل رائع عندما يستخدم السؤال كلمات مختلفة عن الكلمات الموجودة في الإجابة. قد يسأل موظف: «لماذا تتوقف الموافقة على الفواتير؟»، بينما المستند الذي يشرح المشكلة يتحدث عن Approval Workflow Timeout. الكلمات ليست متطابقة، لكن المعنى قريب، وهنا تكون Embeddings مفيدة جدًا.
لكن ماذا لو كان مهندس يبحث عن ERR_GATEWAY_504؟ في هذه الحالة، لا نريد من النظام أن يفهم المعنى فقط. نريده أن يجد هذا النص نفسه، وقد يكون Full Text Search أفضل بكثير.
ثم تأتي مشكلة أخرى. لدينا محادثتان تجيبان عن السؤال نفسه، لكن واحدة منهما من الأسبوع الماضي والأخرى من عام سابق، والبنية التقنية تغيرت منذ ذلك الوقت. هنا تصبح حداثة المعلومة جزءاً من تقييمها.
وقد تكون لدينا نتيجة ممتازة من ناحية المعنى والحداثة، لكنها تخص مشروعًا آخر. أو ربما تكون صحيحة تماماً، لكن الشخص الذي يسأل لا يملك صلاحية الوصول إليها.
لهذا لم نعد نتعامل مع البحث كأداة واحدة. أصبح لدينا Hybrid Retrieval يجمع أكثر من إشارة في العملية نفسها. نستخدم البحث الدلالي عندما يكون المعنى هو المهم، والبحث النصي عندما تكون الكلمات نفسها مهمة، ونستخدم Metadata لتحديد المشروع والمصدر والقسم، ونأخذ حداثة المعلومات في الحسبان، ونستفيد من Knowledge Graph عندما تكون العلاقة بين الأشياء جزءًا من الإجابة.
أما إذا كان السؤال متعلقاً ببيانات منظمة داخل Database، فقد لا نحتاج إلى أي بحث دلالي أصلًا.
وهذه أصبحت قاعدة مهمة لدينا: الـ Brain لا يجب أن يسأل دائماً بالطريقة نفسها، بل يجب أن يعرف أي طريقة تناسب السؤال.
Slack كان من أصعب الأماكن التي حاولنا فهمها
الوثائق سهلة نسبياً. هناك عنوان، وفقرات، وأقسام، وغالباً يستطيع القارئ فهم النص من دون معرفة ما حدث قبله بدقائق.
Slack مختلف.
قد تبدأ المحادثة برسالة تقول: «رجعت المشكلة». ثم يرد شخص: «نفس اللي صار الأسبوع الماضي؟». بعدها يضع مهندس جزءًا من Log، ويبدأ الفريق بمناقشة عدة احتمالات، وبعد عشرين رسالة يكتب أحدهم أن المشكلة كانت في إعدادات API Gateway وأن تعديل الـ Timeout حلها.
إذا تعاملنا مع كل رسالة كقطعة معرفة مستقلة، سنخزن عددًا كبيراً من الرسائل التي لا تعني شيئاً خارج سياقها. وإذا أخذنا المحادثة كلها وحولناها إلى Embedding فقد ندفن أهم معلومة داخل كمية كبيرة من النص.
لذلك بدأنا نتعامل مع المحادثة كوحدة معرفية كاملة. نحتفظ بالنص الأصلي، لكن الـ Brain يحاول أيضًا فهم ما حدث داخله: ما المشكلة التي كان الفريق يناقشها؟ ما الأنظمة المذكورة؟ ما السبب الذي توصلوا إليه؟ ما الحل النهائي؟ من شارك؟ وهل كانت هناك مشاريع أو عملاء أو أجزاء من النظام مرتبطة بالنقاش؟
بهذا يبقى لدينا المصدر الأصلي كاملًا، لكن يصبح لدينا أيضًا تمثيل منظم يمكن البحث فيه بصورة أفضل. عندما يسأل موظف بعد شهرين عن المشكلة نفسها، لا يحتاج النظام إلى قراءة عشرات الرسائل العشوائية حتى يفهم ما حدث.
ثم اكتشفنا أن التلخيص وحده سيجعلنا نخسر تفاصيل مهمة
حل تلخيص المحادثة جزءًا من المشكلة، لكنه خلق مشكلة أخرى. أحيانًا تكون أهم معلومة داخل رسالة صغيرة في منتصف النقاش ولا تصل إلى الملخص النهائي.
قد تتكون المحادثة من عشرات الرسائل حول مشكلة كبيرة، لكن هناك رسالة واحدة تحتوي على اسم إعداد معين أو قيمة محددة يبحث عنها مهندس بعد ثلاثة أشهر. إذا اعتمدنا على Summary واحدة فقط، قد تختفي هذه المعلومة.
لذلك لا نمثل قاعدة المعرفة بطريقة واحدة. يمكن للمحادثة نفسها أن تحمل ملخصاً، وسؤالًا رئيسياً، وحلاً نهائياً، وEntities مرتبطة بها، ومجموعات من الرسائل المهمة، إضافة إلى النص الأصلي.
في بعض الحالات، من المفيد أيضًا جمع الرسائل المتتابعة للشخص نفسه كوحدة واحدة، خصوصًا عندما يكتب الفكرة على عدة رسائل قصيرة. هذا قريب من مفهوم Bursting، حيث نحاول الحفاظ على الإشارة المهمة من دون أن نفصل الرسائل عن السياق الذي يعطيها معناها.
وهنا تغير السؤال بالنسبة لنا. لم يعد: «ما أفضل حجم لـ Chunk واحد من الرسائل؟». أصبح: «بأي طريقة قد يحتاج الإنسان أو الـ Agent إلى العثور على هذه المعرفة لاحقًا؟»
هذا السؤال أعطانا تصميمًا أفضل بكثير.
ليس كل ما يقال داخل الشركة يستحق أن يتحول إلى معرفة
داخل أي مساحة عمل، هناك كمية كبيرة من الكلام الذي لا يحمل قيمة معرفية مستقلة. رسالة مثل «تمام، شكرًا» ليست في قيمة رسالة تشرح السبب الجذري لمشكلة في الإنتاج.
لهذا لا نريد إنشاء Embeddings لكل شيء فقط لأننا نستطيع ذلك.
أثناء المعالجة، يمكن النظر إلى عدة إشارات لقاعدة معرفة ما إذا كان المحتوى يستحق تمثيلًا مستقلًا. قد يحتوي على مصطلح نادر، أو Error Code، أو جزء من Code، أو حل نهائي، أو شرح طويل نسبيًا، أو تفاعل واضح من الفريق يشير إلى أهمية الرسالة. ويمكن استخدام IDF مثلًا للمساعدة في تمييز الكلمات النادرة والمفيدة عن الكلمات العامة التي تتكرر في كل مكان.
الفكرة هنا مهمة: جودة البحث لا تبدأ عندما يكتب المستخدم سؤاله، بل تبدأ قبل ذلك بكثير، أثناء بناء المعرفة نفسها.
إذا امتلأ الـ Index بالمحتوى منخفض القيمة، سنجبر المراحل اللاحقة على إصلاح مشكلة كان من الأفضل منعها من البداية.
الـ Brain يجب أن يتحرك مع الشركة
أفضل إجابة مبنية على معلومات قديمة ما زالت إجابة سيئة.
لهذا لا ننظر إلى إدخال البيانات على أنه عملية تحدث مرة واحدة أثناء إعداد Atmet. الـ Brain يجب أن يتابع التغيرات في المصادر باستمرار.
في Slack مثلًا، يمكن استخدام Socket Mode لاستقبال الأحداث الجديدة عبر WebSocket. عندما يصل رد جديد داخل محادثة موجودة، لا نتعامل معه دائمًا كرسالة منفصلة، بل يمكن إعادة جلب المحادثة كاملة حتى يبقى التمثيل الذي نملكه عنها معبرًا عن آخر ما وصل إليه النقاش.
الفكرة نفسها تنطبق على الوثائق. عندما يتغير مستند، نحدث الجزء المتأثر. وعندما يتغير سجل داخل CRM، يجب أن تنعكس المعلومة الجديدة في العلاقات والـ Metadata. وعندما يتغير الـ Code، لا نريد من Engineering Agent أن تستمر في استخدام نسخة قديمة من الحقيقة.
الـ Brain ليس أرشيف للشركة.
هي صورة حية لها.
البيانات المنظمة يجب أن تبقى منظمة
من الأخطاء التي أردنا تجنبها مبكرًا محاولة تحويل كل شيء إلى نص حتى ندخله في Vector Database.
لنفترض أن X لديه جدول يحتوي على العملاء، وحالة كل عقد من عقود العميل، وتاريخ التجديد، ومدير الحساب، والخطة الحالية. إذا سأل المدير: «كم عقدًا سينتهي هذا الشهر؟»، فلا يوجد سبب منطقي لتحويل كل صف في الجدول إلى فقرة ثم محاولة الوصول إلى الإجابة عبر Embeddings.
هذه بيانات منظمة، ومن الأفضل التعامل معها بهذه الطريقة.
يمكن للـ Brain أن تعرف شكل البيانات وتوفر وسيلة مناسبة للاستعلام عنها. سؤال قد يحتاج SQL، وسؤال آخر يحتاج بحثًا في CRM، وثالث يحتاج Vector Search، ورابع يحتاج المرور عبر Knowledge Graph.
وهنا تظهر نقطة أساسية في تصميم Atmet. الـ Brain ليس Database واحدة نضع فيها كل شيء بالطريقة نفسها. هي طبقة تعرف أنواع المعرفة المختلفة، وتعرف كيف تصل إلى كل نوع بالطريقة الأنسب له.
قبل أن تبحث، يجب أن تعرف أين تبحث
مع زيادة عدد المصادر وطرق الاسترجاع، أصبح تشغيل كل شيء مع كل سؤال قراراً سيئاً. لو سأل المستخدم عن العقود التي تحتاج إلى تجديد هذا الشهر، فلا يوجد سبب للبحث في GitHub. ولو سأل لماذا غير الفريق بنية الـ Authentication في آخر إصدار، فقد تكون الإجابة موزعة بين Slack وGitHub والوثائق التقنية ومحضر اجتماع سابق.
أما إذا كان السؤال: «مين أكثر شخص فاهم التكامل مع SAP؟»، فقد لا تكون الإجابة ملفًا أصلًا. قد تكون شخصًا.
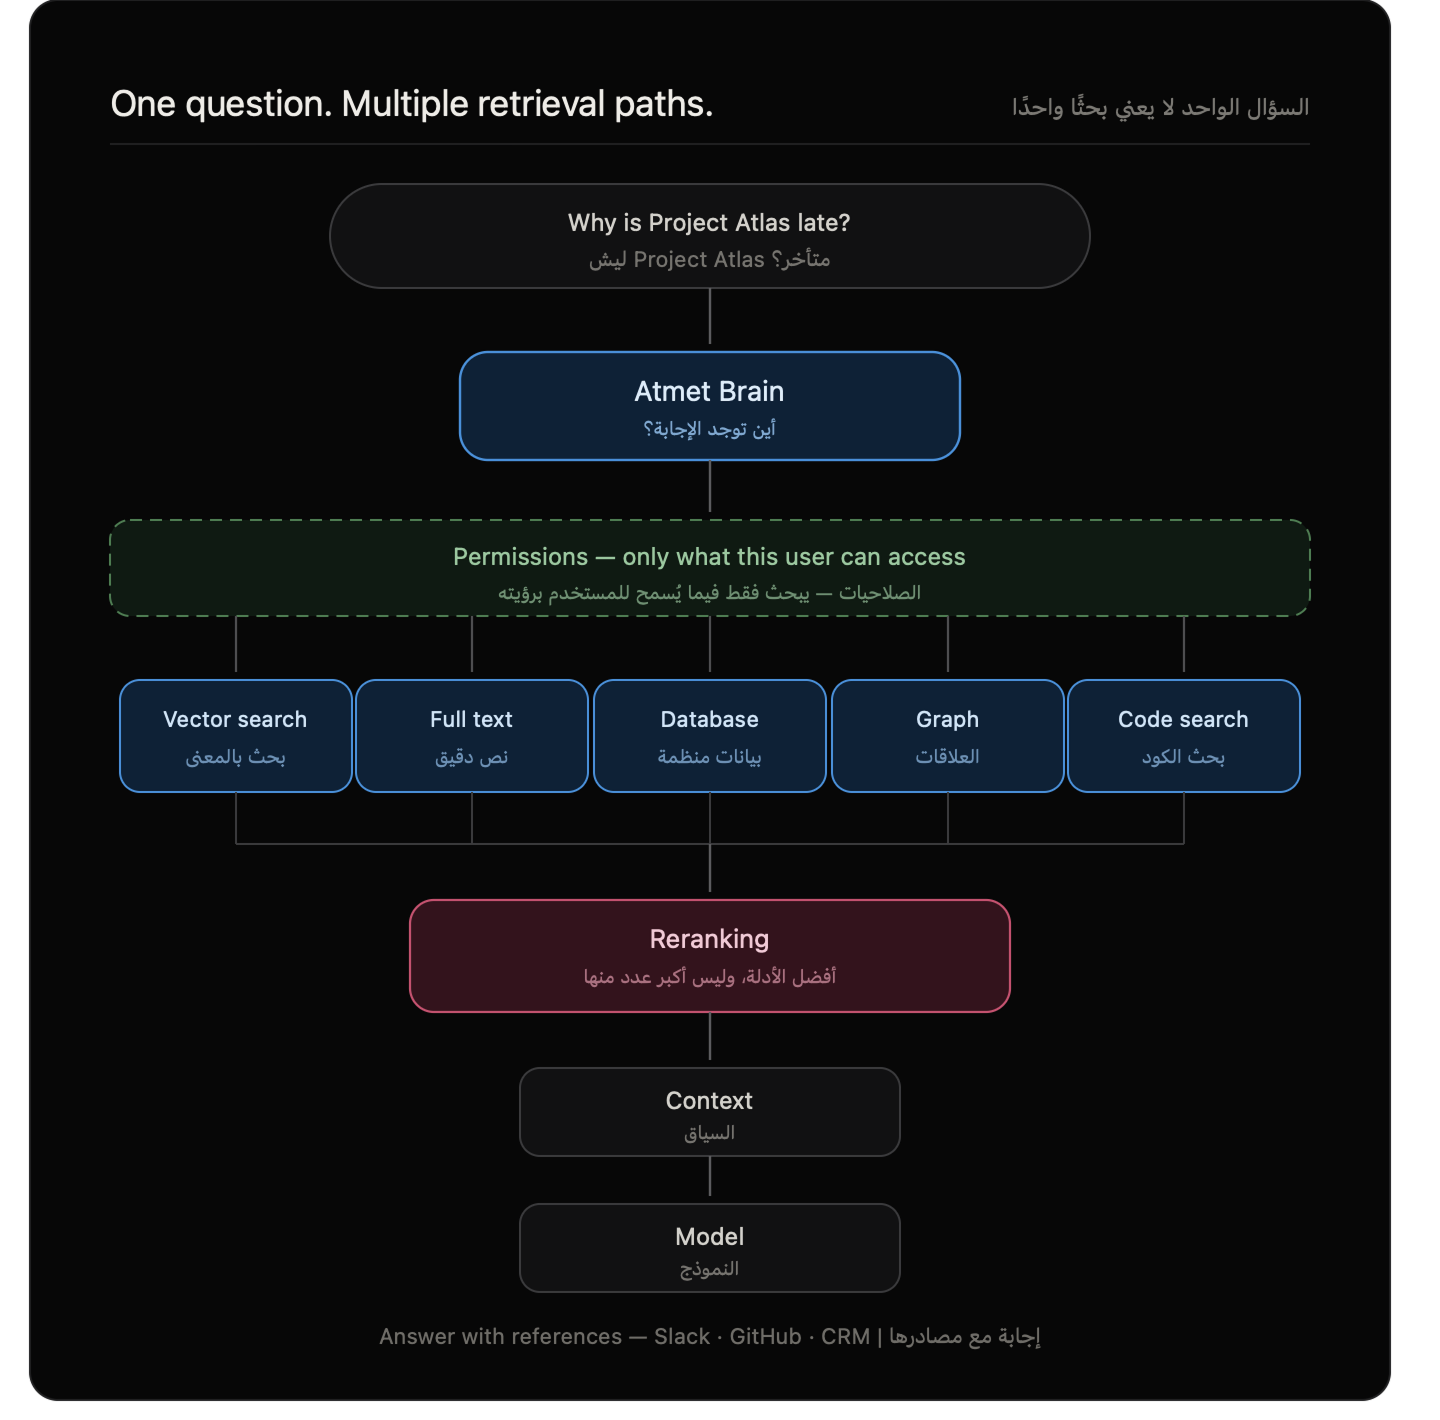
لهذا تمر الأسئلة أولًا بمرحلة تخطيط خفيفة. تنظر الـ Brain إلى السؤال، وهوية المستخدم، وصلاحياته، والمشروع الذي يعمل عليه، والمصادر المتاحة، ثم تحدد الأماكن والوسائل التي تستحق البحث.
بعد ذلك يمكن تشغيل عمليات الاسترجاع المناسبة بالتوازي. البحث النصي يبحث عن التطابقات الدقيقة، والبحث الدلالي يبحث عن المعنى، والاستعلامات المنظمة تجلب الأرقام والسجلات، والـ Knowledge Graph تساعد في العلاقات.
هذا التخطيط لا يحسن الدقة فقط. يقلل أيضًا الوقت والتكلفة وكمية المعلومات التي لا علاقة لها بالسؤال.
العثور على النتائج أسهل من اختيار أفضلها
بعد البحث، قد نصل إلى عشرات النتائج من مصادر مختلفة. المشكلة أن نتيجة ظهرت في المركز الأول داخل Vector Search ليست بالضرورة أفضل نتيجة للإجابة.
قد تكون الوثيقة قريبة لغوياً من السؤال، لكنها تتحدث عن موضوع مختلف قليلًا. وفي المقابل، قد تظهر نتيجة أخرى في أكثر من طريقة بحث، وتكون مرتبطة بالـ Entity الصحيحة داخل Knowledge Graph، وتكون أحدث أيضًا.
لهذا ندمج إشارات الاسترجاع قبل اتخاذ القرار النهائي. إحدى الطرق المفيدة لذلك هي RRF، حيث لا نحاول مقارنة Scores مختلفة لا تعني الشيء نفسه، بل ننظر إلى ترتيب النتيجة في كل طريقة بحث. إذا ظهرت النتيجة في أكثر من مكان، تزداد الثقة بها.
بعد ذلك نزيل التكرار ونمرر أفضل النتائج إلى مرحلة Reranking، حيث يعاد تقييمها مقابل سؤال المستخدم نفسه. الهدف ليس العثور على النصوص التي تشبه السؤال فقط، بل العثور على الأدلة التي تساعد فعلًا في الإجابة عنه.
وفي النهاية، لدينا قاعدة نحاول الحفاظ عليها دائمًا: نحن لا نريد أكبر محتوى ممكن، بل أفضل محتوى ممكن.
إرسال كمية أكبر من المعلومات إلى Model لا يعني بالضرورة نتيجة أفضل. في كثير من الأحيان، كلما كان السياق أنظف وأكثر ارتباطًا بالسؤال، أصبحت الإجابة أفضل، واستهلاك الـ Tokens أقل، والاستجابة أسرع، والتكلفة أقل.
أحيانًا نجد المعلومة الصحيحة، لكننا نحتاج إلى ما حولها
التقسيم إلى أجزاء ضروري للبحث، لكنه قد يفصل الجملة عن السياق الذي يجعلها صحيحة.
قد نعثر على فقرة تقول إن الإجراء مسموح، بينما عنوان القسم فوقها يوضح أن الكلام ينطبق على Enterprise Clients فقط. وقد نعثر على رسالة داخل Slack، لكن الرسالة السابقة هي التي توضح ما المشكلة أصلًا.
لذلك لا تنتهي عملية الاسترجاع عند العثور على الجزء الأفضل. بعد Reranking، تستطيع الـ Brain توسيع السياق عند الحاجة.
إذا كانت النتيجة جزءًا من مستند، يمكن جلب القسم المجاور أو العنوان. وإذا كانت رسالة، يمكن العودة إلى المحادثة التي جاءت منها. وإذا كانت Function، يمكن قراءة الـ Class أو الملف المحيط بها.
العثور على الجملة الصحيحة شيء، وفهمها بالطريقة الصحيحة شيء آخر.
ما لا يستطيع الموظف رؤيته، لا يجب أن يراه الذكاء الاصطناعي
من البداية، لم ننظر إلى الصلاحيات على أنها طبقة يمكن إضافتها في نهاية المشروع.
إذا كان موظف في X لا يستطيع فتح مجلد مالي في Google Drive، فلا يجب أن يستطيع الوصول إلى محتواه من خلال Atmet لمجرد أنه سأل السؤال بطريقة مختلفة.
لهذا ترتبط كل معلومة داخل الـ Brain بمعلومات الوصول الخاصة بها، وتدخل الصلاحيات في عملية الاسترجاع نفسها. لا نبحث في كل شيء ثم نحاول إخفاء بعض النتائج قبل عرضها، بل نبحث من البداية داخل مساحة المعرفة التي يحق للمستخدم الوصول إليها.
هذا يعني أن شخصين يمكن أن يسألا السؤال نفسه ويحصل كل منهما على إجابة مختلفة، لأن كل واحد منهما يرى جزءًا مختلفًا من الشركة.
والأمر نفسه ينطبق على الـ Agents والـ Automations. قد تكون Agent قادرة على قراءة معلومات CRM، لكنها لا تستطيع تعديلها. وقد تكون Automation قادرة على تنفيذ إجراء في نظام العمليات، لكن لا يحق لها الوصول إلى البيانات المالية.
الـ Brain لا تعرف فقط ما الذي تعرفه الشركة.
هي تعرف أيضًا من يستطيع استخدام هذه المعرفة، وما الذي يسمح له أن يفعل بها.
كلما كبرت الشركة، أصبح تحديد نطاق البحث أهم
في البداية، قد يبدو البحث في كل المعرفة أمراً جيداً. لكن مع نمو البيانات، يبدأ هذا النهج بإضافة ضوضاء أكثر من القيمة.
فريق المالية لا يحتاج إلى نتائج من مستودعات Engineering كلما سأل عن فاتورة. ومهندس يعمل على سيرفس معينة لا يريد ظهور Presentations المبيعات في كل بحث.
لهذا يمكن تنظيم المعرفة ضمن Workspaces وDepartments وProjects، من دون الحاجة إلى نسخ البيانات نفسها أكثر من مرة. يمكن لمصدر واحد أن يكون مرتبطًا بأكثر من Project، ويمكن لعميل أن يظهر في مساحة المبيعات والعمليات في الوقت نفسه.
وعندما يأتي السؤال، تستخدم الـ Brain هوية المستخدم، والسياق الحالي، وطبيعة السؤال لتحديد مساحة البحث المناسبة.
كلما استطعنا تضييق المساحة قبل البحث، قل المحتوى غير المفيد، وتحسنت النتائج، وأصبحت Models تحتاج إلى سياق أقل.
وفي بعض الأحيان، أفضل إجابة ليست مستنداً، بل شخصاً
مع تراكم العلاقات داخل Knowledge Graph، ظهرت إمكانية أخرى لم تكن مرتبطة بالبحث في الوثائق فقط.
يمكن أن يسأل الموظف: «مين أكثر شخص فاهم هذا الجزء من النظام؟»
قد نعرف الإجابة لأن مهندساً معيناً شارك في عدة محادثات حول الموضوع، وراجع Pull Requests مرتبطة به، وكتب وثائق عنه، وكان جزءًا من اجتماعات تناولت المشكلة نفسها.
لا يعني ذلك أن نعلن شخصًا خبيرًا بسبب رسالة واحدة. لكن مع تراكم الأدلة، يمكن للـ Brain بناء صورة أفضل عن أماكن الخبرة داخل الشركة.
وهذا مهم، لأن المعرفة داخل الشركات ليست كلها مكتوبة.
أحيانًا أهم شيء يستطيع Atmet إخبارك به هو: الشخص الذي يجب أن تتحدث معه موجود هنا.
هنا يظهر الفرق بين Knowledge Base وعقل Atmet
لو توقفنا عند البحث، لكان لدينا نظام Enterprise Search قوي.
لكن هذا ليس ما نبني Atmet من أجله.
الـ Brain هي نواة Atmet لأنها لا تخدم واجهة النموذج فقط. بل يمكن أن تستخدم Atmet للإجابة عن سؤال، ويمكن أن تعتمد عليه ببناء Agent قبل اتخاذ عدة خطوات، ويمكن أن تستخدمه للأتمتة أوللحصول على المعلومة الصحيحة قبل تنفيذ إجراء.
لنأخذ مثالًا بسيطاً. يكتب المستخدم: «جهزني لاجتماعي غداً مع X».
هذه ليست عملية بحث واحدة. قد يحتاج الـ Agent إلى الاطلاع على CRM لمعرفة حالة العميل، وقراءة آخر المراسلات، ومراجعة الاجتماعات السابقة، ومعرفة المشاكل المفتوحة، والاطلاع على حالة المشروع، وربما اكتشاف فاتورة متأخرة أو مشكلة ظهرت في Support قبل يومين.
الـ Brain توفر الفهم والسياق. الـ Agent تستخدمهما لتنفيذ المهمة.
وفي مكان آخر، قد تسأل النموذج سؤالًا بسيطًا عن سياسة داخلية وتستخدم Brain نفسها للوصول إلى الإجابة. وقد تبني وكيل أتمتة كل صباح، وتسأل الـ Brain عن المشاريع التي تجاوزت موعدها، ثم تتخذ إجراءً في الأنظمة المرتبطة.
عقل واحد، واستخدامات مختلفة.
وهذا هو الأساس الذي نبني Atmet حوله.
لا نريد أن يتعلم كل Agent الشركة من الصفر
بدون Brain مشترك، بناء Agent جديد يعني غالباً إعادة جزء كبير من العمل نفسه. نربط الأدوات، ونضيف الملفات، ونشرح أسماء المشاريع، ونحدد الأشخاص، ونبني صلاحيات جديدة، ثم نعيد العملية عندما نحتاج Agent أخرى.
مع Atmet، نريد أن يحدث العكس.
عندما نبني Agent جديد، تدخل إلى شركة أصبحت مفهومة أصلًا. مصادر المعرفة مرتبطة، والعلاقات موجودة، والصلاحيات معروفة، وطرق الاسترجاع جاهزة.
ما نحتاج إلى تحديده هو دور الـ Agent: ماذا نريد منه أن يفعل؟ ما الأدوات التي يمكنه استخدامها؟ ما المعلومات التي يستطيع رؤيتها؟ وما الإجراءات المسموح له بتنفيذها؟
نحن لا نبني عقلًا جديدًا لكل Agent.
نبني أدوارًا وقدرات مختلفة فوق عقل واحد للشركة.
الـ Model ليست ذاكرة الشركة
من البداية، لم نرد أن يعتمد Atmet Brain على Model واحد.
قد يستخدم اليوزر OpenAI في مهمة، وModel من Anthropic في مهمة أخرى، وLocal Model داخل بنيته التحتية عندما تكون حساسية البيانات أعلى.
لا يجب أن تتغير معرفة الشركة عندما تتغير الـ Model.
الـ Brain تملك السياق، والـ Model تستخدم ما تحتاج إليه منه.
هذا الفصل مهم لأنه يسمح لنا باستخدام النموذج المناسب لكل مهمة. Model صغيرة قد تكون كافية للتصنيف أو التوجيه، بينما تحتاج مهمة أخرى إلى Reasoning أقوى. وبعض العمليات يمكن تنفيذها داخل بيئة العميل باستخدام Local Model.
في جميع هذه الحالات، لا نعيد بناء المعرفة.
عقل الشركة يبقى نفسه.
ومع كل هذا، يجب أن تبقى التجربة بسيطة
خلف سؤال واحد قد تحدث أشياء كثيرة. قد تحدد الـ Brain أولًا أين تبحث، ثم تستدعي أكثر من مصدر، وتدمج النتائج، وتطبق الصلاحيات، وتراجع حداثة المعلومات، وتعيد ترتيب الأدلة، وتوسع السياق، ثم ترسل ما تحتاجه الـ Model.
لكن المستخدم لا يريد أن يرى كل هذا.
هو يريد أن يسأل:
«ليش Project Atlas متأخر؟»
ثم يحصل على إجابة واضحة، مع المصادر التي بُنيت عليها.
قد تكون الإجابة مبنية على بيانات من نظام إدارة المشاريع، ومحادثة في Slack، ومحضر اجتماع، وPull Request في GitHub. هذا التعقيد يجب أن يبقى مسؤولية Atmet، لا مسؤولية الشخص الذي طرح السؤال.
كلما أصبحت الـ Brain أكثر قدرة في الخلفية، يجب أن تصبح التجربة أبسط في الأمام.
ماذا تغير لدى X العميل الذي ذكرناه بالبداية؟
قبل بناء الـ Brain، كان استخدام الذكاء الاصطناعي يعتمد كثيراً على الشخص نفسه. الموظف الذي يعرف أين توجد الملفات، وأي Channel يجب أن يبحث فيها، ومن المسؤول عن المشروع، وما الذي يجب أن يضعه في الـ Prompt، يستطيع الحصول على نتيجة جيدة.
الموظف الجديد لا يملك هذا السياق.
والـ Agent الجديد لا يستعطيع أيضًا.
بعد بناء الـ Brain، تغيرت نقطة البداية. أصبحت هناك طبقة معرفة مشتركة تفهم مصادر الشركة وعلاقاتها وصلاحياتها، ويمكن للبشر والـ Models والـ Agents والـ Automations استخدامها بطرق مختلفة.
لم يعد على المستخدم أن يعرف أين توجد المعلومة قبل أن يسأل عنها. ولم تعد كل Agent بحاجة إلى Knowledge Base خاصة بها. ولم تعد كل Automation تبدأ من مجموعة قواعد ثابتة لا تفهم ما يحدث حولها.
أصبحت الشركة نفسها هي السياق.
لم نرد أن يتحول المشروع إلى Data Migration تستمر سنة
هناك شيء آخر كان مهمًا لنا منذ البداية: لا نريد أن نقول لـ X إن عليه ترتيب كل بيانات السنوات السابقة قبل أن يستطيع استخدام Atmet.
الشركات الحقيقية ليست نظيفة بهذا الشكل. هناك ملفات قديمة، وأسماء مشاريع تغيرت، وFolders لا يعرف أحد لماذا سميت بهذه الطريقة، ومحادثات طويلة، وأنظمة بنتها فرق مختلفة في سنوات مختلفة.
هذا هو الواقع الذي يجب أن تعمل فيه الـ Brain.
نبدأ من البيانات الموجودة، نربط المصادر، نبني الشكل الموحد للمعرفة، نستخرج العلاقات، نطبق الصلاحيات، وننشئ الفهارس، ثم يتحسن العقل مع الوقت.
عندما يضاف مستند جديد، تدخل معرفة جديدة. عندما تتغير بيانات العميل، تتغير الصورة. عندما ينتهي نقاش بقرار، يصبح القرار جزءًا من السياق. وعندما يتغير الـ Code، تتحدث المعرفة التقنية معه.
Atmet Brain ليست نسخة نأخذها من الشركة يوم الإعداد.
هي نظام يعيش معها.
ما الذي نبنيه فعلًا في Atmet؟
تشغيل Model أصبح أسهل. بناء Agent أصبح أسهل. ربط API وتنفيذ Automation أصبح أسرع بكثير مما كان عليه قبل سنوات قليلة.
لكن السؤال الأصعب بقي نفسه:
ماذا يعرف الذكاء الاصطناعي عن الشركة قبل أن يبدأ العمل؟
هل يعرف العملاء والمشاريع؟ هل يعرف القرارات السابقة؟ هل يعرف أي معلومة هي الأحدث؟ هل يعرف العلاقات بين الأنظمة والأشخاص؟ هل يعرف ما يستطيع المستخدم رؤيته؟ وهل يستطيع الوصول إلى كل هذا من غير أن نشرح الشركة له من البداية في كل مرة؟
هذا هو السبب الذي يجعل الـ Brain نواة Atmet.
وكلما أضفنا نظامًا جديدًا، أو معرفة جديدة، أو علاقة جديدة، لا يستفيد منها جزء واحد فقط من Atmet. يستفيد منها العقل كله، وكل ما يعمل فوقه.
في النهاية، نحن لا نريد أن نعطي الشركات أداة ذكاء اصطناعي جديدة لكل مشكلة.
نريد أن نبني لها عقلًا واحدًا يفهمها، ثم نجعل الذكاء الاصطناعي كله قادرًا على العمل فوق هذا الفهم.